点击右上角 微信好友
 朋友圈
请使用浏览器分享功能进行分享
编者按:在科幻影视作品中,形态各异的机器人常常以战力强大的钢铁战士形象走入大众视野。如今,具身智能技术的发展让科幻逐渐变成现实。搭载感知、决策、执行全套能力的智能载体,可以是无人机、履带排爆机器人、四足机器狗,也可以是机械外骨骼,它们走出数字虚拟空间,进入真实物理世界感知环境、自主行动、协同作业,实现“让AI拥有身体去做事”。以国防应用为重要场景的具身智能技术已经成为当前人工智能、无人系统领域的重点研究方向。
为此,中国科协科普部、中国指挥与控制学会、光明网联合策划推出“战场来了新成员”具身智能系列科普视频,邀请北京化工大学副教授、中国指挥与控制学会具身智能专业委员会委员沈甜雨担任主讲专家,立足科研一线,以通俗化、大众化的表达,深度解读具身智能走进现实战场与现实生活背后的原理与发展前景。
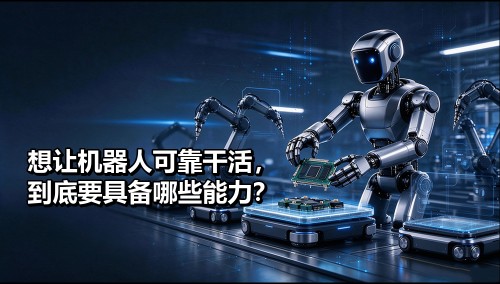
先来个灵魂拷问:要让一台机器人真正能干活,到底靠什么?答案是,看得见、想得出、做得到。翻译成专业点的话,对应三个模块:感知、决策、执行。
先说说感知,就是机器人的“感官”。人看东西靠眼睛,听声音靠耳朵,摸东西靠手。机器人也一样,但它的“感官”比人多得多。普通摄像头能看颜色和形状;深度相机和激光雷达,能测出距离和空间结构,就像给了机器人一双“3D眼睛”;还有麦克风、温度传感器、气体传感器……
还有力觉和触觉传感器,机器人抓东西的时候,能感受到“我碰到了没有、用了多大劲”。这个太重要了,后面咱们还会说道。
而且,只靠一种传感器往往不够。比如光线暗的时候,摄像头看不清,但雷达不受影响。多种传感器互相补充,这叫“多模态感知”。
光看见还不行,还得知道该怎么办。这就是第二个模块——决策,机器人的“大脑”。
举个例子,你跟机器人说“把桌上的杯子拿给我”。听起来很简单对不对?但机器人得干多少事呢?首先,它得从桌子上一堆东西里认出哪个是杯子;然后,得判断杯子能不能抓、从哪个角度抓;其次,得规划手臂怎么伸过去,并且不能碰到桌上其他东西;最后,抓起来以后还得送到你面前。
这一整套,从“看懂”到“想好怎么做”,就是决策的活儿。
现在特别火的视觉-语言-动作模型,也就是VLA模型,干的就是这事,把眼睛看到的、耳朵听到的语言指令,直接转换成动作。Google的Gemini Robotics、英伟达的GR00T,走的都是这个路子。
想好了,还得能做出来。这就是第三个模块——执行。电机、减速器、关节、夹爪、灵巧手……这些是机器人的“肌肉”和“手脚”。
别小看执行。就说抓鸡蛋这件事,抓太松,掉了;抓太紧,碎了。怎么办?这就得靠刚才说的力觉和触觉传感器了。机器人边抓边感受,抓着抓着力道不对,赶紧调整。
所以你看,感知和执行不是完全分开的,它们是联动的。
说到这儿,重点来了。真正厉害的具身智能,不是感知特别强,或者决策特别牛,也不是执行特别精准,而是这三个模块能形成一个闭环。
什么意思?就是机器人不是一次性算好所有动作就不管了,而是边做边看,边看边调整。伸手的时候发现杯子挪位置了,重新定位;走路的时候前面突然有人,赶紧减速绕行;抓东西感觉手感不对,停下来重试。
真实世界时时刻刻在变,杯子会被碰歪,地面会有坑,人会突然走过来。所以“边做边感知、边感知边调整”,比一次性算得再精准都管用。
还有一层不能忽略,就是安全。机器人在真实环境里工作,尤其是跟人一起的时候,必须有安全边界。哪些地方不能进?动作力度不能超过多少?有人靠近了是不是要减速甚至停下?这些安全机制,很多是用传统控制方法和规则来做的,不纯粹靠AI学习。因为安全这件事,容不得试错。
所以,具身智能的进步,从来不是某一个模块突然变强了,而是感知、决策、执行,还有安全机制,这一整套系统共同进步的结果。
监 制
光明网科普事业部
科学审核
沈甜雨
策 划
肖春芳 宋雅娟
编 导
肖春芳
统 筹
杜 颖
文字编辑
李 瑾(实习)
联合出品
中国科协科普部
中国指挥与控制学会
光明网
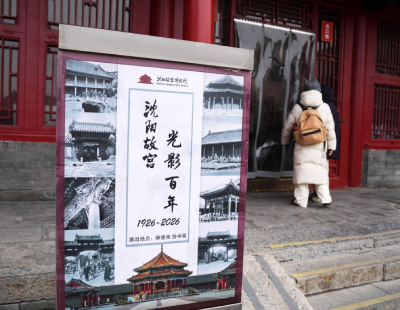
沈阳故宫博物院举办“沈阳故宫 光影百年”图片展
超百家世界500强企业代表将参加APEC工商领导人峰会